읽는 데 7분
DBDelve의 100만 행, 스크롤보다 먼저 볼 결과 메모리
쿼리 결과가 커지면 DB가 답을 보내 준 뒤에도 클라이언트가 버거울 수 있어요. DBDelve는 이 구간을 겨냥한 도구예요. 현재 코드에서는 받은 행을 메모리에 계속 쌓지만, 화면에는 보이는 범위의 행을 그려요. 스크롤이 가벼운 것과 결과 전체가 메모리를 적게 차지하는 것은 별개의 문제예요.
Shayan Abbas가 만든 Rust·GPUI 기반 데스크톱 DB 클라이언트로, macOS·Linux·Windows를 지원해요. 2026년 11월 10일 확인한 최신 릴리스는 0.7.1, 현재 라이선스는 GPL-3.0이에요. 아래 성능 수치는 저자의 구버전 시험이고, 여기서는 실행 대신 코드와 공식 문서를 대조했어요.
어떤 화면에서 결과를 보나요
왼쪽에서 테이블을 고르고, 위쪽 SQL 에디터에서 쿼리를 쓰고, 아래쪽 표에서 결과를 보는 구성이에요. PostgreSQL뿐 아니라 MySQL, SQLite, MongoDB 등 여러 엔진을 지원해요.
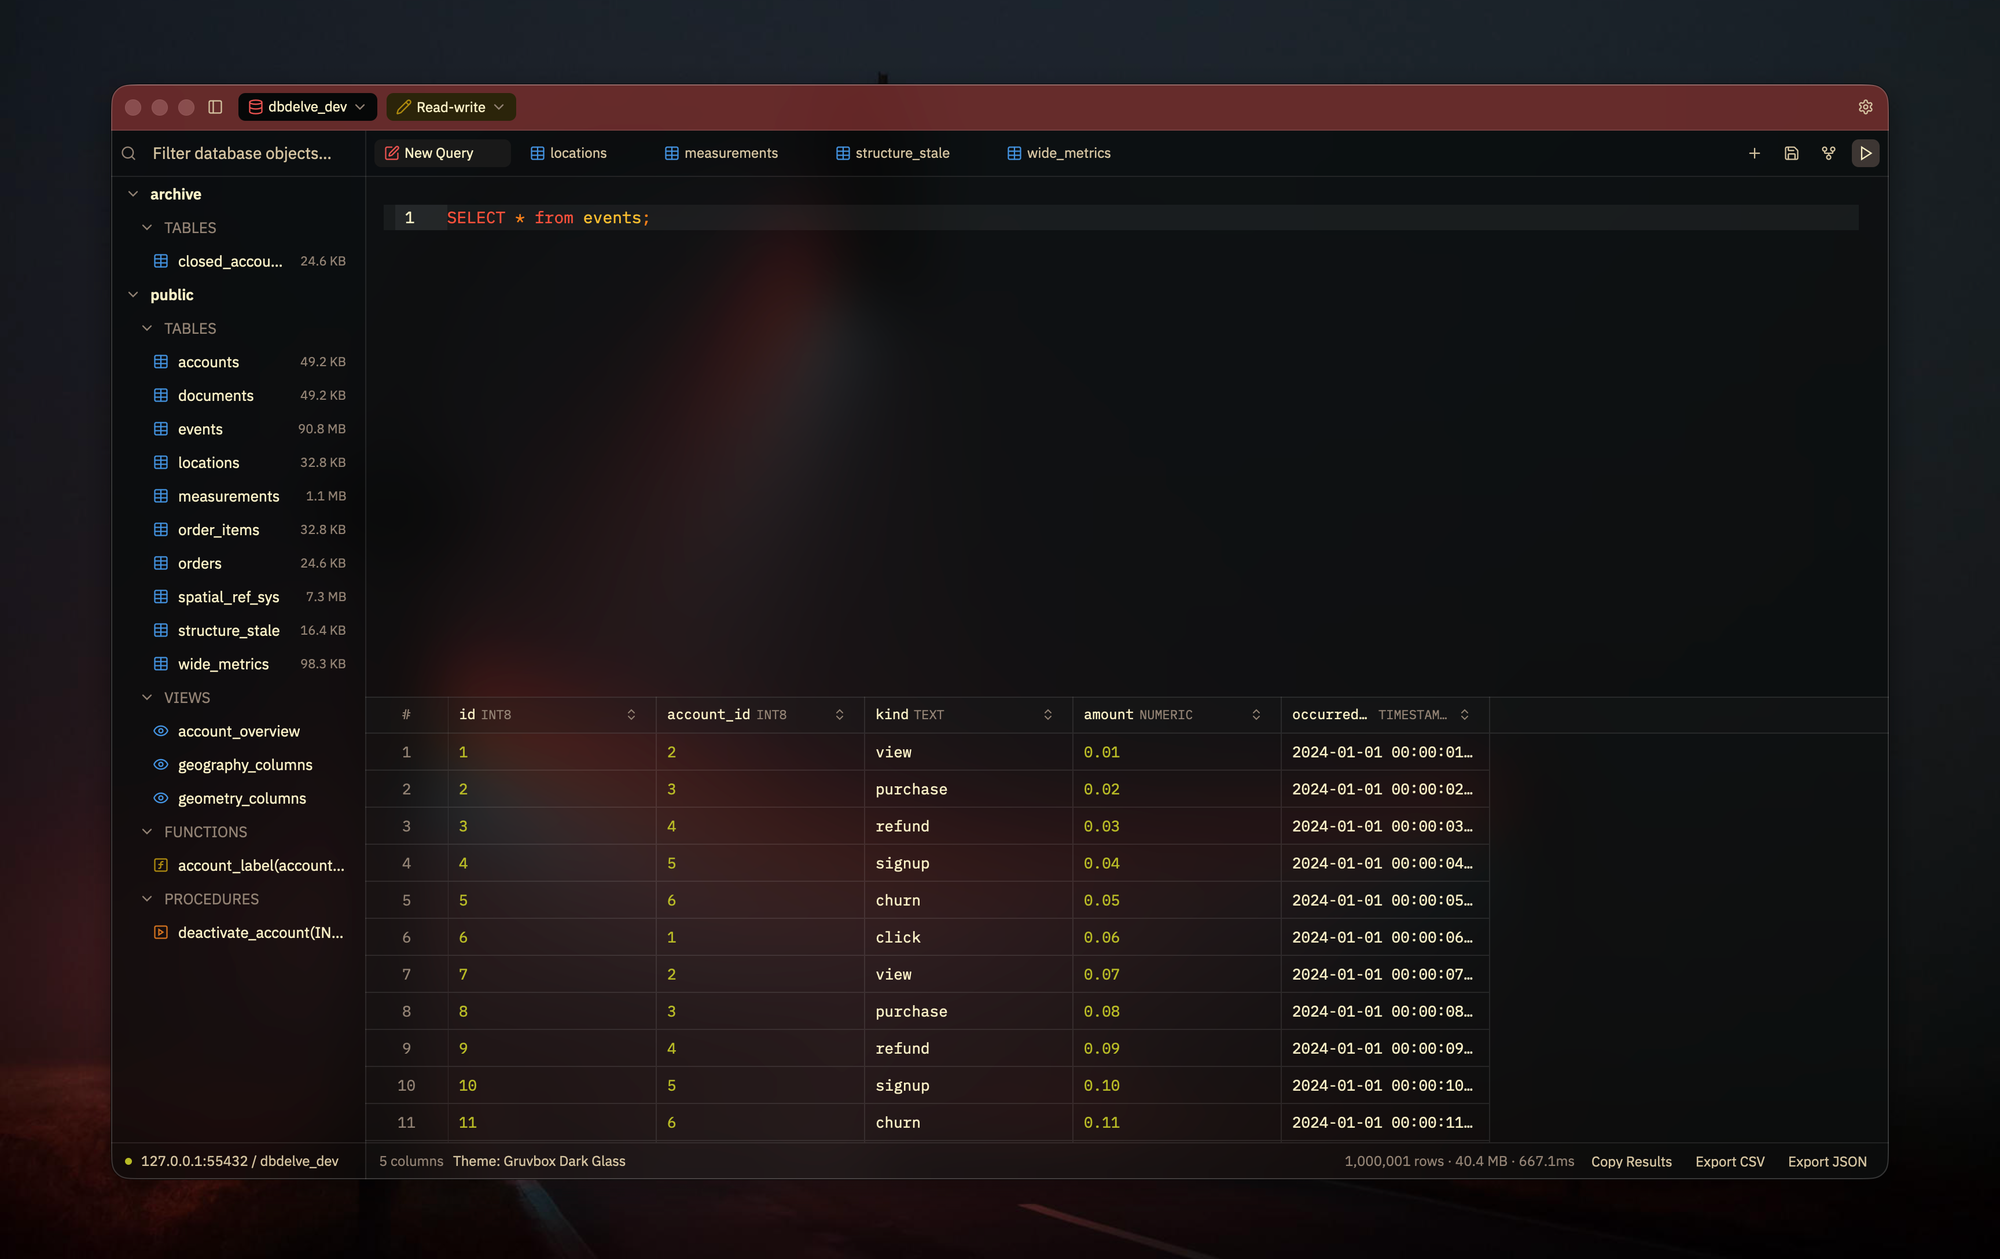
제작자의 공식 스크롤 데모에서는 큰 결과 안에서 위치를 옮긴 뒤 다른 테이블로 전환하는 모습도 볼 수 있어요. 이 영상은 동작을 보여 주는 예시로 보고, 처리 시간 비교는 아래 시험 조건으로 따로 읽는 편이 좋아요.
17GB 비교는 무엇을 측정했나요
저자의 시험은 2026년 10월 11일 DBDelve 0.3.6과 DBeaver 25.3.1을 비교한 것이에요. M1 Pro·메모리 32GB의 Mac에서 PostgreSQL 15를 사용했어요. DB 서버는 amd64 이미지여서 Apple Silicon 위에서 에뮬레이션으로 실행됐고요.
100만 행·107개 컬럼을 두 앱 모두 끝까지 가져오도록 조회 제한을 풀었어요. DBeaver의 최대 Java 힙도 16GB로 늘렸어요. 아래는 크기별로 앱마다 5회 측정한 중앙값이에요.
| 100만 행 결과 | DBDelve | DBeaver |
|---|---|---|
| 첫 행 표시 | 약 0.1초 | 약 0.1초 |
| 전체 결과 표시 완료 | 55.6초 | 207.5초 |
| 결과 보관 중 프로세스 메모리 | 4.9GB | 17GB |
select 1로 교체한 뒤 5초 후 |
344MB | 17GB |
메모리는 결과 데이터 크기가 아니라 Activity Monitor에 표시되는 프로세스 footprint예요. DBeaver의 17GB는 측정 도구가 10GB 이상을 정수 GB로 표시한다는 단서도 있어요. 결과를 바꾼 뒤 남은 수치만으로 메모리 누수를 판정할 수는 없어요.
여기서 도입 판단을 바꾸는 건 DBeaver 공식 문서의 기본 동작이에요. 처음에는 200행을 가져오고, 끝까지 스크롤하면 다음 묶음을 가져와요. 전체 결과 가져오기는 별도 동작이며, 큰 결과에서는 멈춤이나 메모리 부족이 생길 수 있다고 안내해요.
따라서 평소 몇백 행을 보고 필터를 바꾸는 사람에게 이 표는 도구를 바꿀 충분한 이유가 되기 어려워요. 반대로 넓은 결과를 끝까지 받은 뒤 여러 위치를 오가는 사람이라면, 전체 적재 시간과 보관 메모리를 함께 비교해 볼 이유가 있어요. 첫 행을 보는 시간은 이 시험에서 둘이 같았거든요.
코드에서는 보관과 화면 그리기가 나뉘어요
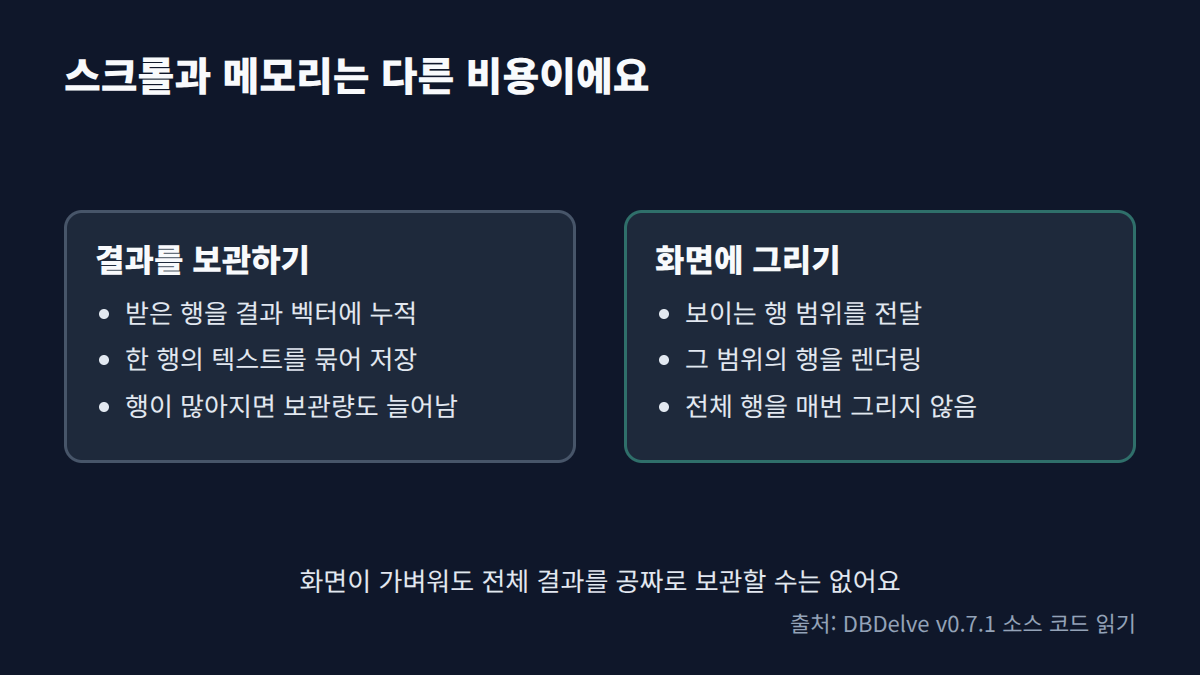
0.7.1의 Row는 셀마다 별도 문자열을 두는 대신, 한 행의 텍스트를 한 버퍼에 모으고 각 셀의 끝 위치를 따로 저장해요. 행 저장 코드에서 그 구조와 값을 꺼내는 방식을 볼 수 있어요. 짧은 값이 여러 컬럼에 든 행을 보관할 때, 값 외에 붙는 관리 정보를 줄이려는 설계예요.
그래도 받은 데이터를 없애는 것은 아니에요. 결과는 Vec<Row>에 담기고, 추가 행을 받으면 기존 벡터에 붙여요. 한편 화면 쪽은 보이는 행 범위를 받아 그 범위를 렌더링해요. 이런 방식으로 보이지 않는 행을 매번 그리는 일을 피하는 것을 가상화라고 불러요.
재시작할 때도 경계가 하나 더 있어요. 저장 코드는 결과 스냅샷에 앞쪽 최대 5,000행을 남기고, 원래 전체 행 수는 별도로 기록해요. 이 한도는 실행 중 결과 표의 행 제한이 아니라 재시작용 저장 한도예요. 큰 결과를 탐색하는 용도로 검토하되, 결과 탭을 전체 데이터의 보관본으로 삼지는 마세요.
제 생각엔 DBDelve를 검토할 출발점은 “DBeaver보다 무조건 빠른가”보다 “내가 결과를 얼마나 많이 받아서 어떻게 훑는가”예요. 소량 조회가 주라면 기존 도구의 행 단위 가져오기를 유지하는 쪽이 먼저이고, 전체 결과 탐색이 잦다면 내 쿼리의 행 수와 컬럼 폭을 기준으로 비교하는 편이 맞아요.
확인한 범위
- 기준일: 2026-11-10.
- 직접 한 것: 고정 커밋의 행 저장·추가·화면 렌더링·스냅샷 코드를 읽고, 저자 시험 조건을 DBeaver 공식 조회 문서와 대조했어요. 기존 한국어 소개와 내용 범위를 비교하고 공식 화면과 스크롤 데모의 추출 프레임을 판독했어요.
- 읽은 것: DBDelve README·BENCHMARKS·릴리스·라이선스, DBeaver Result set navigation 문서.
- 확인하지 못한 것: 앱을 실행하거나 벤치마크를 재현하지 않았어요. 최신 버전끼리의 성능, 한국어 입력과 각 DB 엔진별 동작은 확인하지 못했어요.
출처
 GitHub
 DBeaver