읽는 데 5분
AI가 뽑은 재생수가 사람마다 다를 때, 카카오 추천팀이 나눈 세 가지 기준
같은 서비스의 ‘재생수’를 물었는데 동료와 내 AI가 서로 다른 값을 내놓으면, 어느 쪽을 믿어야 할까요. 카카오 추천팀이 겪은 일은 계산 실수보다 앞단에 있었어요. 한쪽은 영상 플레이어의 로그를, 다른 쪽은 앱의 로그를 골랐거든요. 두 로그는 영상 소비를 기록하는 기준부터 달랐어요.
카카오가 10월 28일 공개한 개발기는 팀이 합의한 기준을 어디에 두고 함께 관리할 것인가에 초점을 맞춰요. 분석 에이전트를 여러 사람이 쓰기 시작한 팀이라면 참고할 만한 사례예요.
데이터의 뜻과 분석 방법을 나눠요
기존에도 에이전트는 지침 파일인 CLAUDE.md를 읽고, 데이터를 조회할 명령인 SQL을 작성해 팀의 데이터 처리 환경에서 실행한 뒤 리포트를 썼어요. 하지만 어떤 로그가 목적에 맞는지, 무엇과 비교해야 하는지 같은 지식은 개인의 지침이나 머릿속에 흩어져 있었어요.
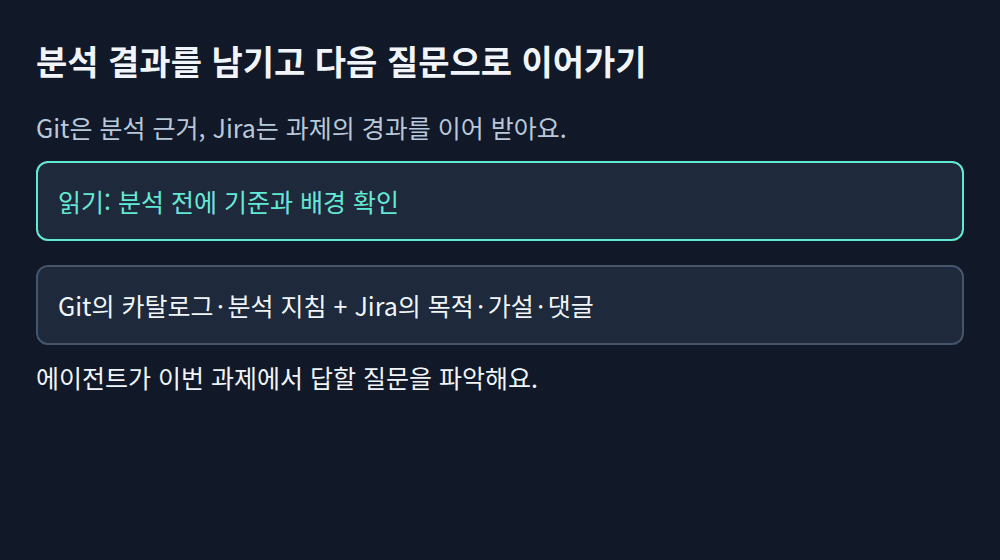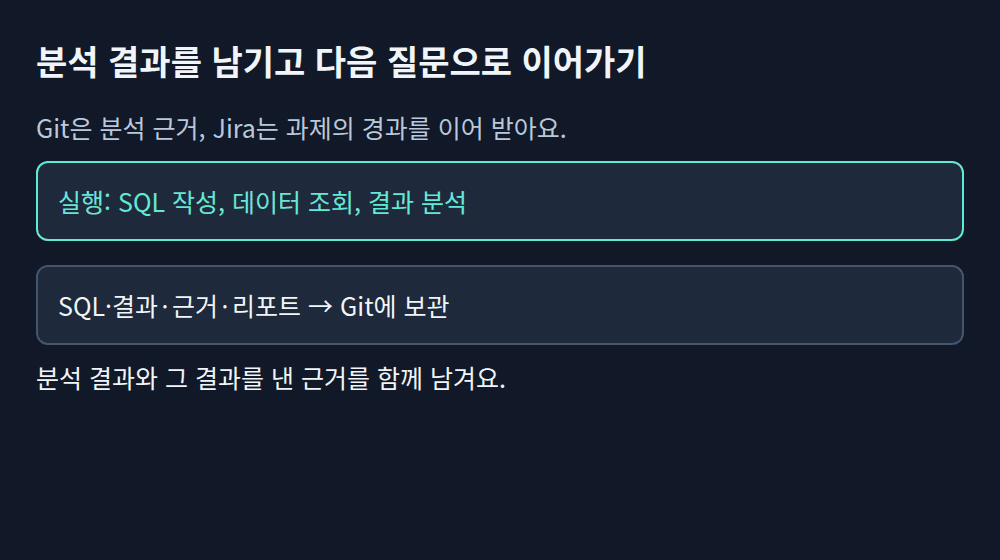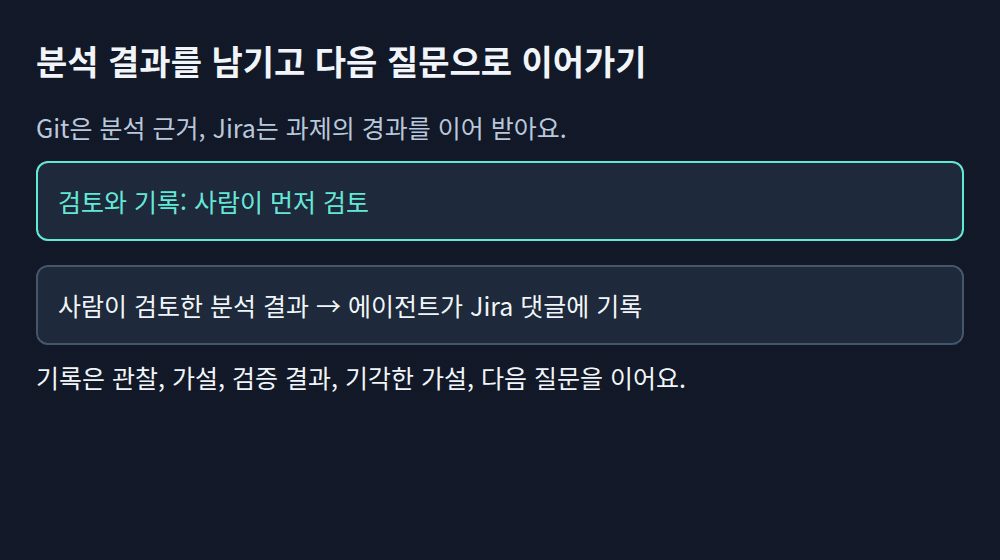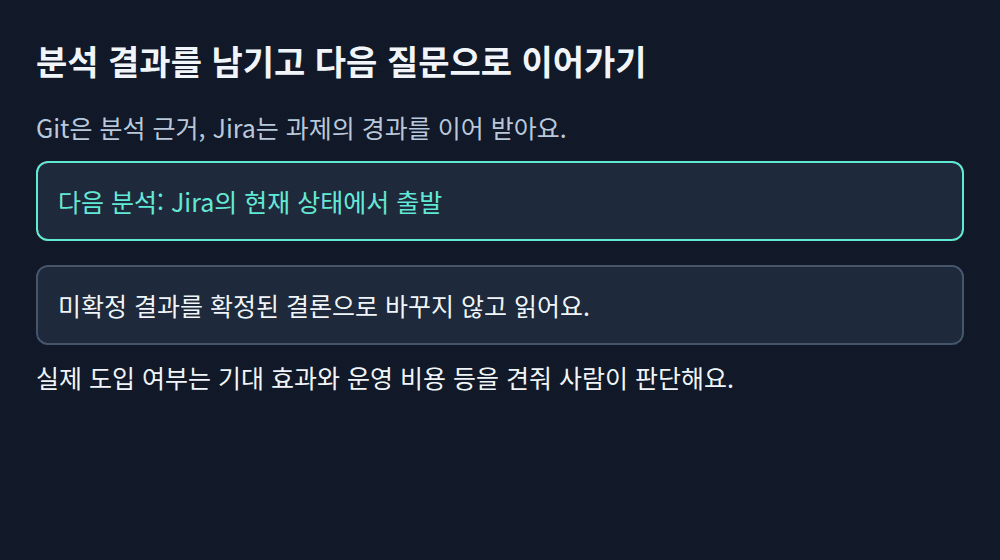
추천팀은 분석 전에 읽을 정보를 세 묶음으로 나눴어요.
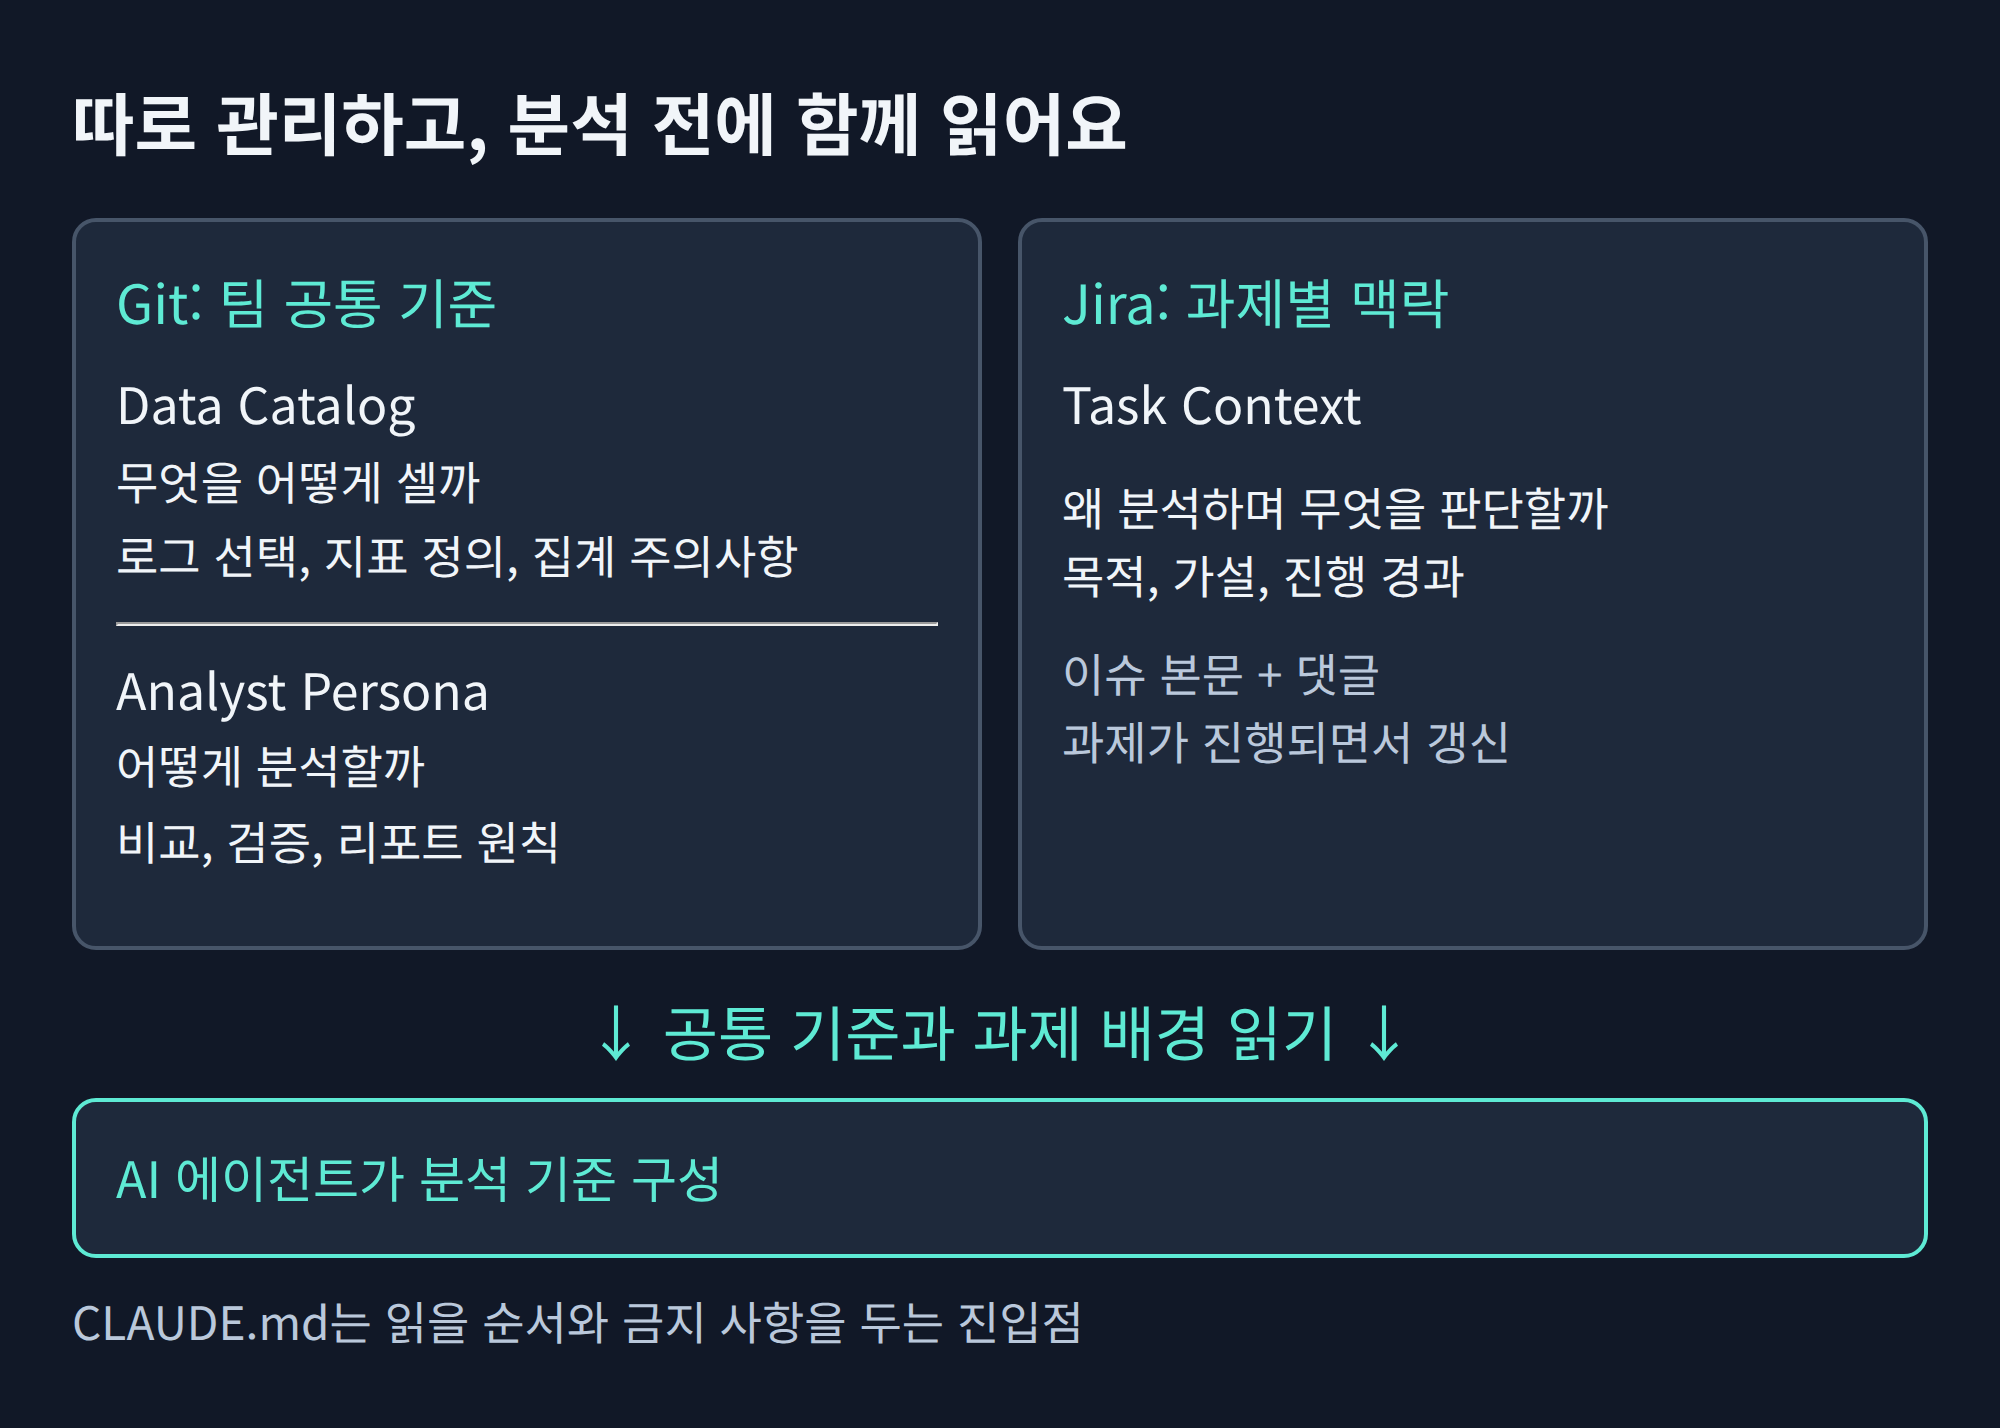
나눈 기준은 정보의 수명이에요. 재생수의 정의는 여러 과제에서 재사용하지만, “이번 실험은 효과가 아직 미확정이니 더 관찰한다”는 기록은 해당 과제가 진행되면서 바뀌죠. CLAUDE.md에는 읽을 순서와 금지 사항을 두고, 자세한 지식은 각 문서와 Jira에서 가져오게 했어요.
테이블에 컬럼이 있다고 써도 되는 건 아니에요
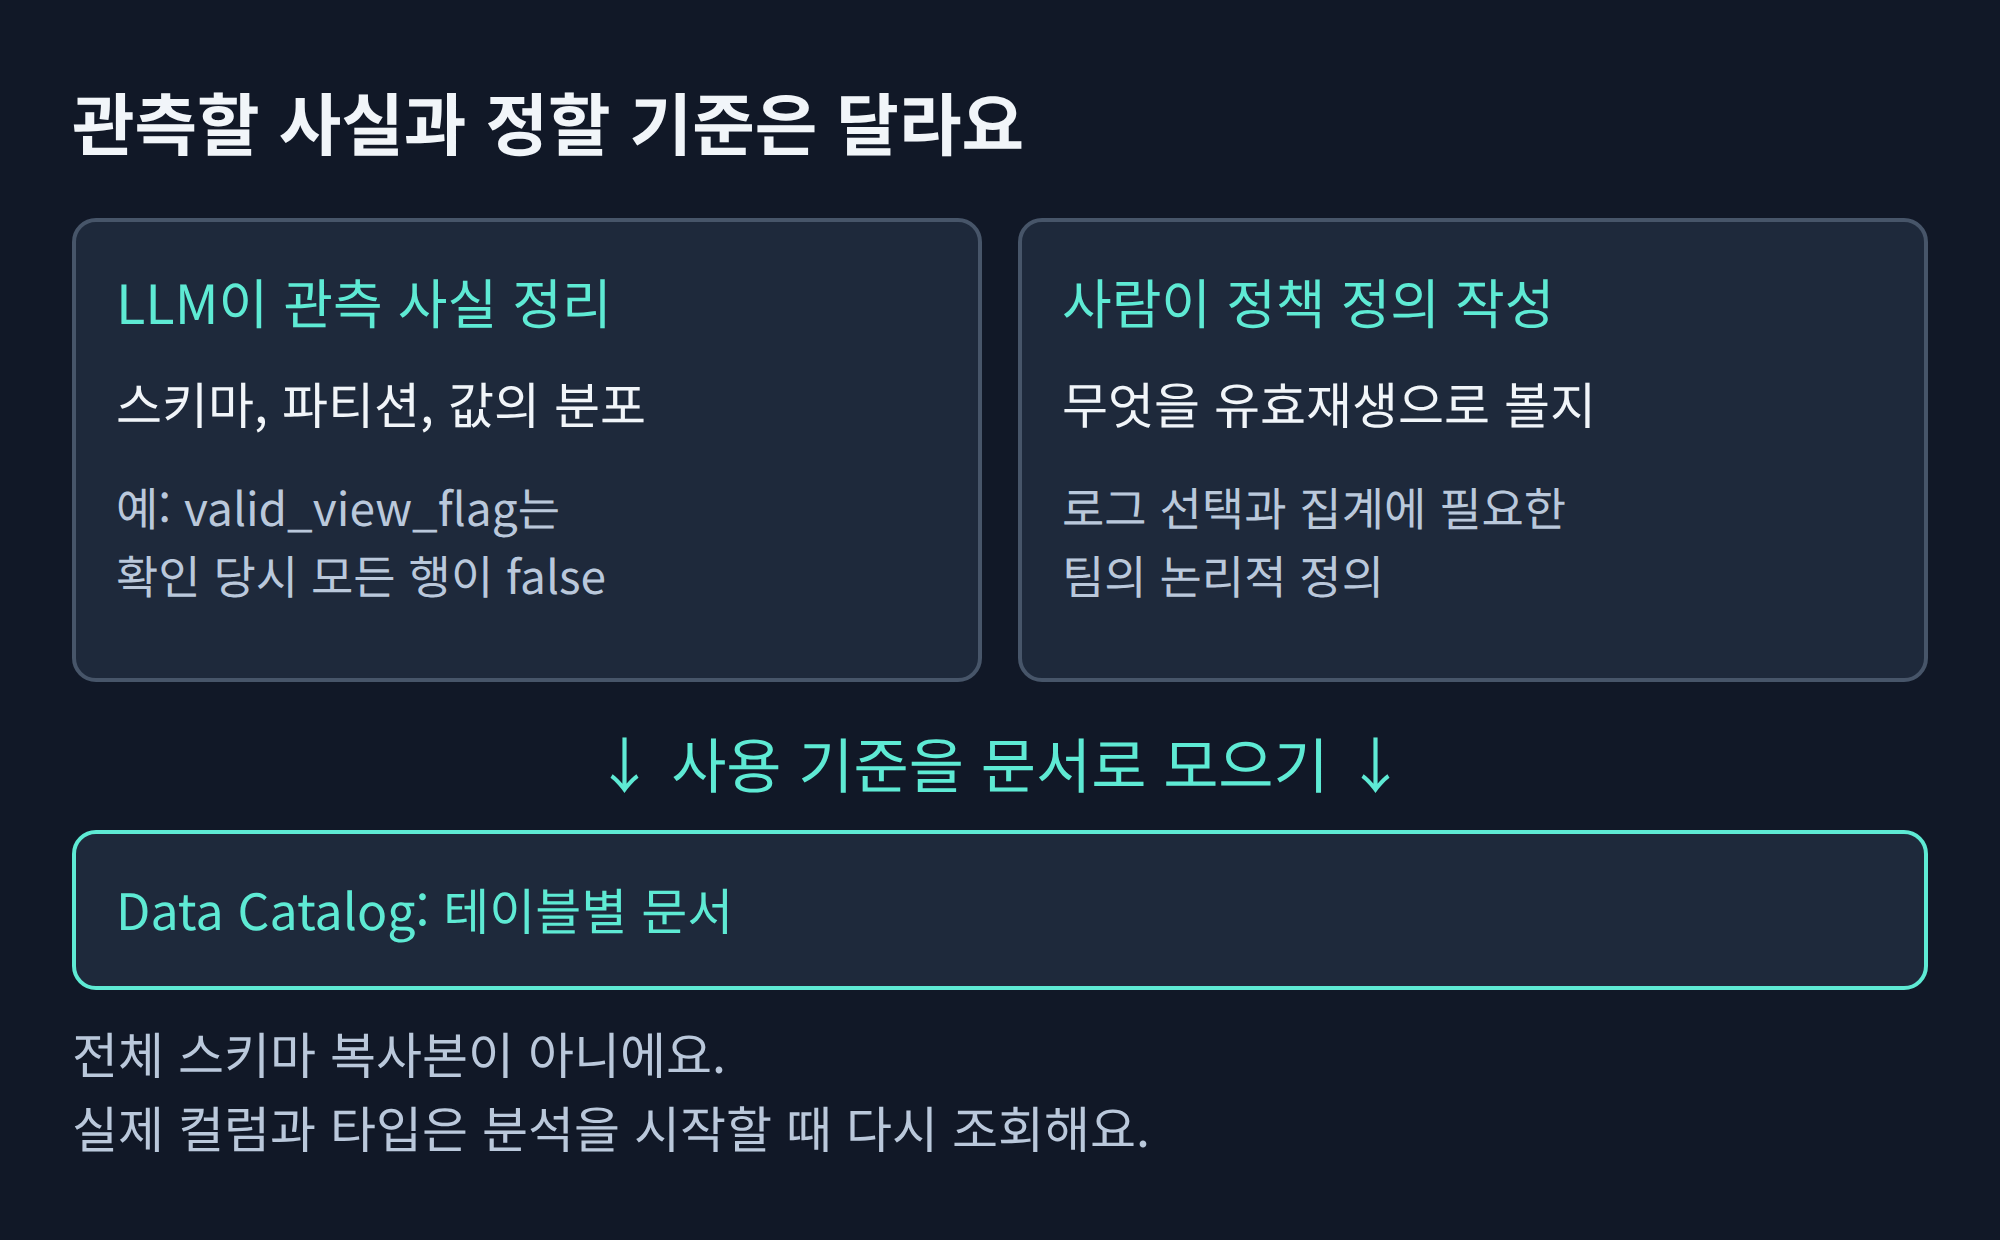
카탈로그는 데이터베이스의 전체 구조를 복사한 문서가 아니에요. 그 테이블을 쓸 때 헷갈릴 지점을 적어 둔 사용 기준에 가까워요. 실제 컬럼과 타입은 분석을 시작할 때 다시 조회해요.
원문의 예시에는 valid_view와 valid_view_flag가 함께 있어요. 이름만 보면 둘 다 유효한 재생을 나타낼 것 같지만, 카탈로그에는 후자가 확인 당시 모든 행에서 false였으니 판정에 쓰지 말라고 적혀 있어요. 이런 차이는 컬럼 이름만 읽어서는 알기 어렵죠.
이전 결론 대신 이번 과제의 경과를 읽어요
분석 지침에는 이상 신호를 사용자 행동 변화로 단정하기 전에 로그 수집이나 서비스 변경부터 확인하라는 원칙이 들어가요. 반면 과거 과제의 결론을 일반 규칙으로 가져오지는 않아요. 어떤 과제에서는 시청시간이, 다른 과제에서는 소비한 영상 수가 성공 기준일 수 있기 때문이에요.
원문은 수치와 식별 정보를 뺀 가상 재구성 사례도 보여 줘요. 중간 분석에서는 손해는 확인하지 못했지만 이득도 확정하지 못해 관측 기간을 늘렸고, 후속 분석은 그 미확정 상태에서 출발해요. 나중에 합의한 적용 조건을 충족해도 실제 도입 여부는 운영 비용 등을 견줘 사람이 따로 판단했어요.
이 개발기의 가치는 정확도 향상률 같은 숫자보다, 결과를 비교할 출발점을 맞춘 방식에 있어요. 팀은 같은 로그와 집계 규칙, 검증 절차에서 분석을 시작하게 됐다고 설명해요.
확인한 범위
- 기준일: 2026-11-01.
- 읽은 것: 카카오 추천팀의 개발기 전체와 공개된 폴더 구조, 카탈로그 및 분석 댓글 예시를 대조했어요.
- 읽지 못한 것: 팀의 내부 저장소, 실제 Jira 이슈, 원시 로그와 분석 산출물은 확인하지 못했어요.
- 직접 해보지 못한 것: 카카오의 분석 환경을 실행하거나 결과 일치율을 측정하지 않았어요. 본문 실험 경과는 원문이 가상으로 재구성한 사례예요.
출처
 카카오테크