읽는 데 8분
AI가 만든 영상, 소리도 제대로 나올까요? earshot을 수치부터 시험했어요
AI에게 제품 소개 영상을 만들게 했다고 해 볼게요. 화면은 그럴듯한데 소리가 아예 빠졌다면요? 효과음 한 군데만 너무 크게 튀어도 결과물은 어색해져요. 코드를 만드는 일과 완성된 소리를 확인하는 일 사이에는 별도 검사 단계가 필요해요.
earshot은 소리 파일을 받아 크기와 시간 같은 수치, 어떤 소리와 가까운지에 대한 설명을 돌려줘요. 에이전트는 그 결과를 읽고 파일을 다시 고칠 수 있죠. 이 글은 2026-10-30에 실행한 기본 측정 시험을 바탕으로 해요. 이번 수정에서는 당시 기록과 공식 문서를 다시 대조했으며, 도구를 재실행하지 않았어요.
답을 아는 소리부터 넣었어요
시험한 것은 모델 없이 동작하는 measure 명령이에요. 입력은 직접 만든 4초짜리 WAV였어요. 앞뒤 1초는 무음, 가운데 2초는 1 kHz의 일정한 시험음으로 채우고, 좌우에 같은 신호를 넣었어요. 진폭은 디지털 상한의 절반이에요. 여기에 100개 시점의 좌우 값을 상한인 +1로 덮어쓴 변형과, 완전한 무음 파일도 따로 만들었어요.
python -m earshot measure clean.wav --json
python -m earshot measure clipped.wav --json
python -m earshot measure silence.wav --json
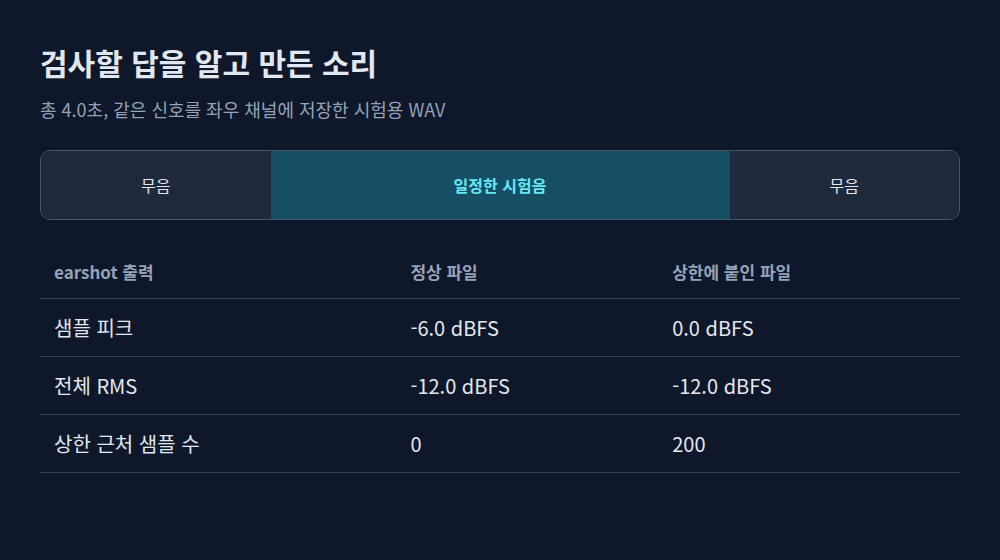
세 명령은 모두 정상 종료했어요. 정상 파일의 길이는 4.0초, 가장 큰 샘플 값은 -6.0 dBFS, 전체 구간의 RMS는 -12.0 dBFS였어요. dBFS는 디지털 상한을 0으로 놓은 크기이고, RMS는 파형 전체의 평균적인 에너지를 보는 값이에요. 생성한 배열에서 별도로 계산한 값과 출력의 소수점 정밀도에서 일치했어요.
상한에 붙인 변형은 피크 0.0 dBFS, clipped_samples 200을 돌려줬어요. 절댓값 0.999 이상인 샘플을 채널별로 센 값이에요. 100개 시점에 좌우 두 채널이니 200개죠. 손상된 구간이 200곳이라는 뜻은 아니에요.
눈에 띄는 건 두 파일의 RMS가 모두 -12.0으로 표시됐다는 점이에요. 짧은 문제 구간은 전체 평균과 반올림에 가려질 수 있어요. 평균 크기 하나만 보지 않고 피크와 상한 근처 샘플 수도 함께 확인할 이유가 생겨요.
숫자로 돌려줘도 해석은 필요해요
앞뒤 절반을 무음으로 만들었는데, 정상 파일의 digital_silence_frac는 0.5가 아니라 0.5208이었어요. 이 값은 ‘무음 구간의 길이’가 아니라, 좌우를 평균 낸 파형에서 절댓값이 아주 작은 샘플의 비율이에요. 시험음이 0을 지나는 순간도 포함돼요. 따라서 이 숫자만으로 영상에 몇 초짜리 공백이 있다고 단정하면 안 돼요.
완전 무음 파일의 요약문은 디지털 무음이며 음량과 주파수 등의 값은 의미가 없다고 알려줬어요. 그런데 JSON에는 centroid_hz: 11999도 남아 있었어요. 주파수 중심을 나타내는 항목인데, 무음 파일에서는 해석에서 제외해야 하는 값이에요.
에이전트에 붙인다면 먼저 무음 여부를 확인하고, 의미 있는 신호일 때 나머지 지표를 읽는 순서가 필요해 보여요. 수치가 나왔다는 사실과 그 수치를 써도 된다는 판단은 별개였어요.
영상과 소리를 한 장에 모으면
제작자가 공개한 sheet 출력 예시는 이 도구의 더 큰 쓰임을 보여줘요. 영상 프레임 아래에 소리 사건, 주파수별 에너지를 색으로 나타낸 스펙트로그램, 파형과 음량을 함께 놓아요. ‘효과음이 화면 전환에 맞춰 나오는가’를 시간축에서 살펴보는 용도예요.
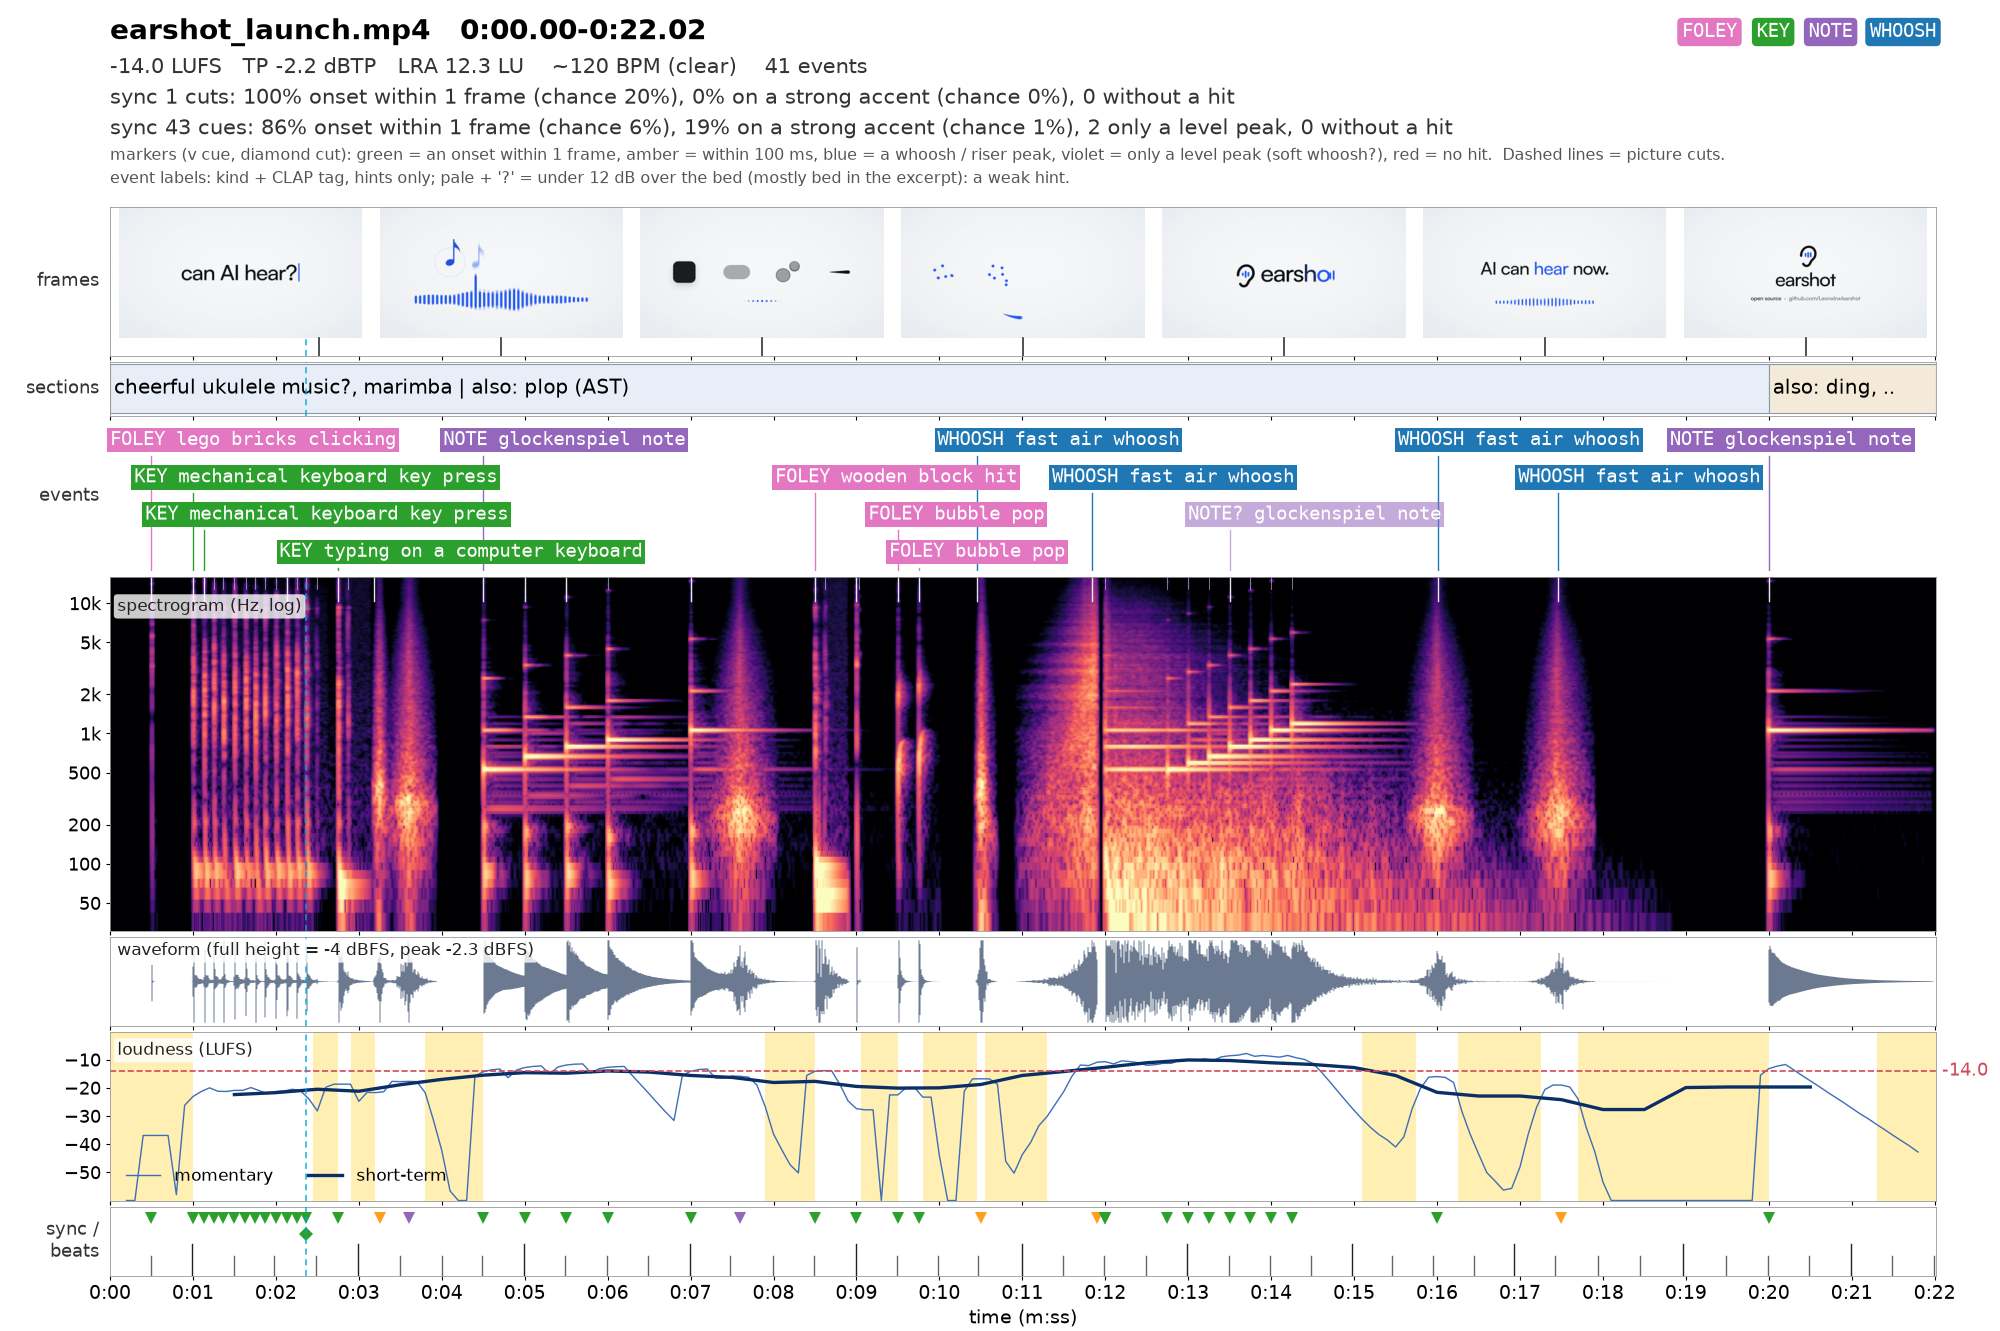
원본 시트와 설명은 공식 README에서, 제작자의 소리 결과물은 22초 소개 영상이 있는 공식 릴리스에서 볼 수 있어요. 영상의 재생과 청취 품질은 이번에 확인하지 않았어요.
이런 분석은 기본 측정과 달리 모델을 사용해요. README는 원하는 설명에 가까운 효과음을 고르는 match와 rank, 긴 녹음에서 해당 소리가 나는 순간을 찾는 find도 안내해요. 예를 들어 키보드 효과음 후보 중 ‘묵직한 키 입력’에 가까운 파일을 고르고, 쓸 구간을 찾는 식이죠. critique는 참고 영상들의 스타일에 비춰 수정할 지점을 제안해요.
시작 조건은 Python 3.10 이상과 ffmpeg/ffprobe예요. CPU에서 실행하며, 모델 기능의 첫 사용에는 약 1.1 GB 다운로드가 필요하다고 해요. 터미널 명령 외에 Python 코드와 코딩 에이전트가 도구로 호출하는 연결 방식인 MCP 서버도 제공해요. 설치와 연결 절차는 공식 안내로 남겨둘게요.
어디까지 맡기면 좋을까요
당시 단순한 시험 입력에서는 길이와 피크, RMS, 상한 근처 샘플 수, 무음 샘플 비율이 기대값과 맞았어요. 에이전트가 만든 오디오를 다음 단계로 넘기기 전에 ‘완전 무음인가’, ‘예상한 길이와 크기인가’를 확인하는 작은 검사부터 붙일 만해요.
공식 한계 문서는 음악에 묻힌 효과음의 이름과 장르, 분위기를 힌트로만 보라고 해요. 예쁜 소리인지, 브랜드에 어울리는지, 말의 내용이 무엇인지, 사용 허가가 있는지는 판단하지 못해요. 점수 기준도 제작자가 고른 제품·AI 소개 영상 등 7편에서 가져온 것이어서 다른 스타일의 영상에는 맞지 않을 수 있어요.
제 생각엔 ‘AI의 귀’라는 별명보다 소리 작업에 붙이는 검사 도구로 보면 쓰임이 더 잘 보여요. 평균 하나로 짧은 문제를 놓치지 않는지, 무음에서 의미 없는 숫자를 읽고 있지는 않은지까지 검사 순서에 넣는 거예요.
확인한 범위
- 기준일: 원시험 2026-10-30, 문서 재대조와 편집 2026-10-31. earshot 0.4.0, 소스 커밋
591fa3e028032e6dce56620a20e932e35667e8d8기준이에요. - 기존 시험: 로컬 호스트의 Python 가상환경(venv)에서 48 kHz 스테레오 WAV 3개에
measure --json을 실행했어요. venv는 패키지 분리이지 Docker 같은 보안 격리가 아니에요. 모델 다운로드를 끄고 기본 수치를 원본 배열과 대조했어요. - 이번 확인: 당시 대화에 보존된 시험 코드와 실행 결과, 고정 커밋의 README와 LIMITS를 대조했어요.
- 미검증: 전체 설치, 의미 인식 모델, MCP 연결, 영상 분석과 효과음 생성, 실제 녹음·음악, 청취 평가, LUFS 등 나머지 측정값의 정확도예요. 공식 시트는 제작자의 예시이며 제 시험 결과가 아니에요.
출처
 GitHub
보조 자료: 시험 당시 README, 판단할 수 있는 것과 없는 것.