읽는 데 7분
LLM 호출을 전부 없애지 않고 비용 줄이기, 토스 SNAP
상품 이름과 옵션을 보고 같은 상품인지 판단하는 일을 AI에 맡겼다고 해볼게요. 처음에는 잘 돌아가는데, 요청이 쌓일수록 호출 비용과 기다리는 시간이 부담스러워져요. 그렇다고 작은 모델로 전부 바꾸자니 어려운 상품까지 제대로 구분할지 걱정되죠.
토스가 기술 블로그에 소개한 SNAP(Selective Native AI Processing)은 그 사이를 택해요. LLM은 문장을 이해하고 생성하는 대규모 언어 모델이에요. SNAP은 작은 모델의 결과 중 높은 신뢰도로 처리한 것만 채택하고, 나머지는 기존 LLM으로 보내는 방식이에요. 여기서 내재화는 외부의 범용 모델에 맡기던 작업을 자체 모델로 처리한다는 뜻이에요.
같은 상품인지 고르는 데 긴 답변은 필요 없어요
문서를 길게 요약하는 일과 두 상품이 같은지 고르는 일에는 서로 다른 능력이 필요해요. 토스는 후자처럼 입력과 출력 범위가 명확한 작업부터 골랐어요. 브랜드, 모델명, 용량, 색상, 구성품 등을 읽고 같은 판매 단위인지 분류하는 문제예요.
이런 작업에는 기존 LLM의 판단 기록을 학습 자료로 쓸 수 있어요. 다만 작은 모델이 모든 요청에서 큰 모델과 같은 수준이 될 때까지 기다리지는 않아요. 충분히 믿을 수 있는 구간만 골라 쓰는 게 SNAP의 핵심이에요.
처리 순서는 간단해요.
- 요청을 먼저 작은 모델에 보내요.
- 모델이 결과와 함께 내놓은 신뢰도 점수가 정해진 기준 이상이면 그 결과를 써요.
- 기준에 못 미치면 기존 LLM을 추가로 호출해요.
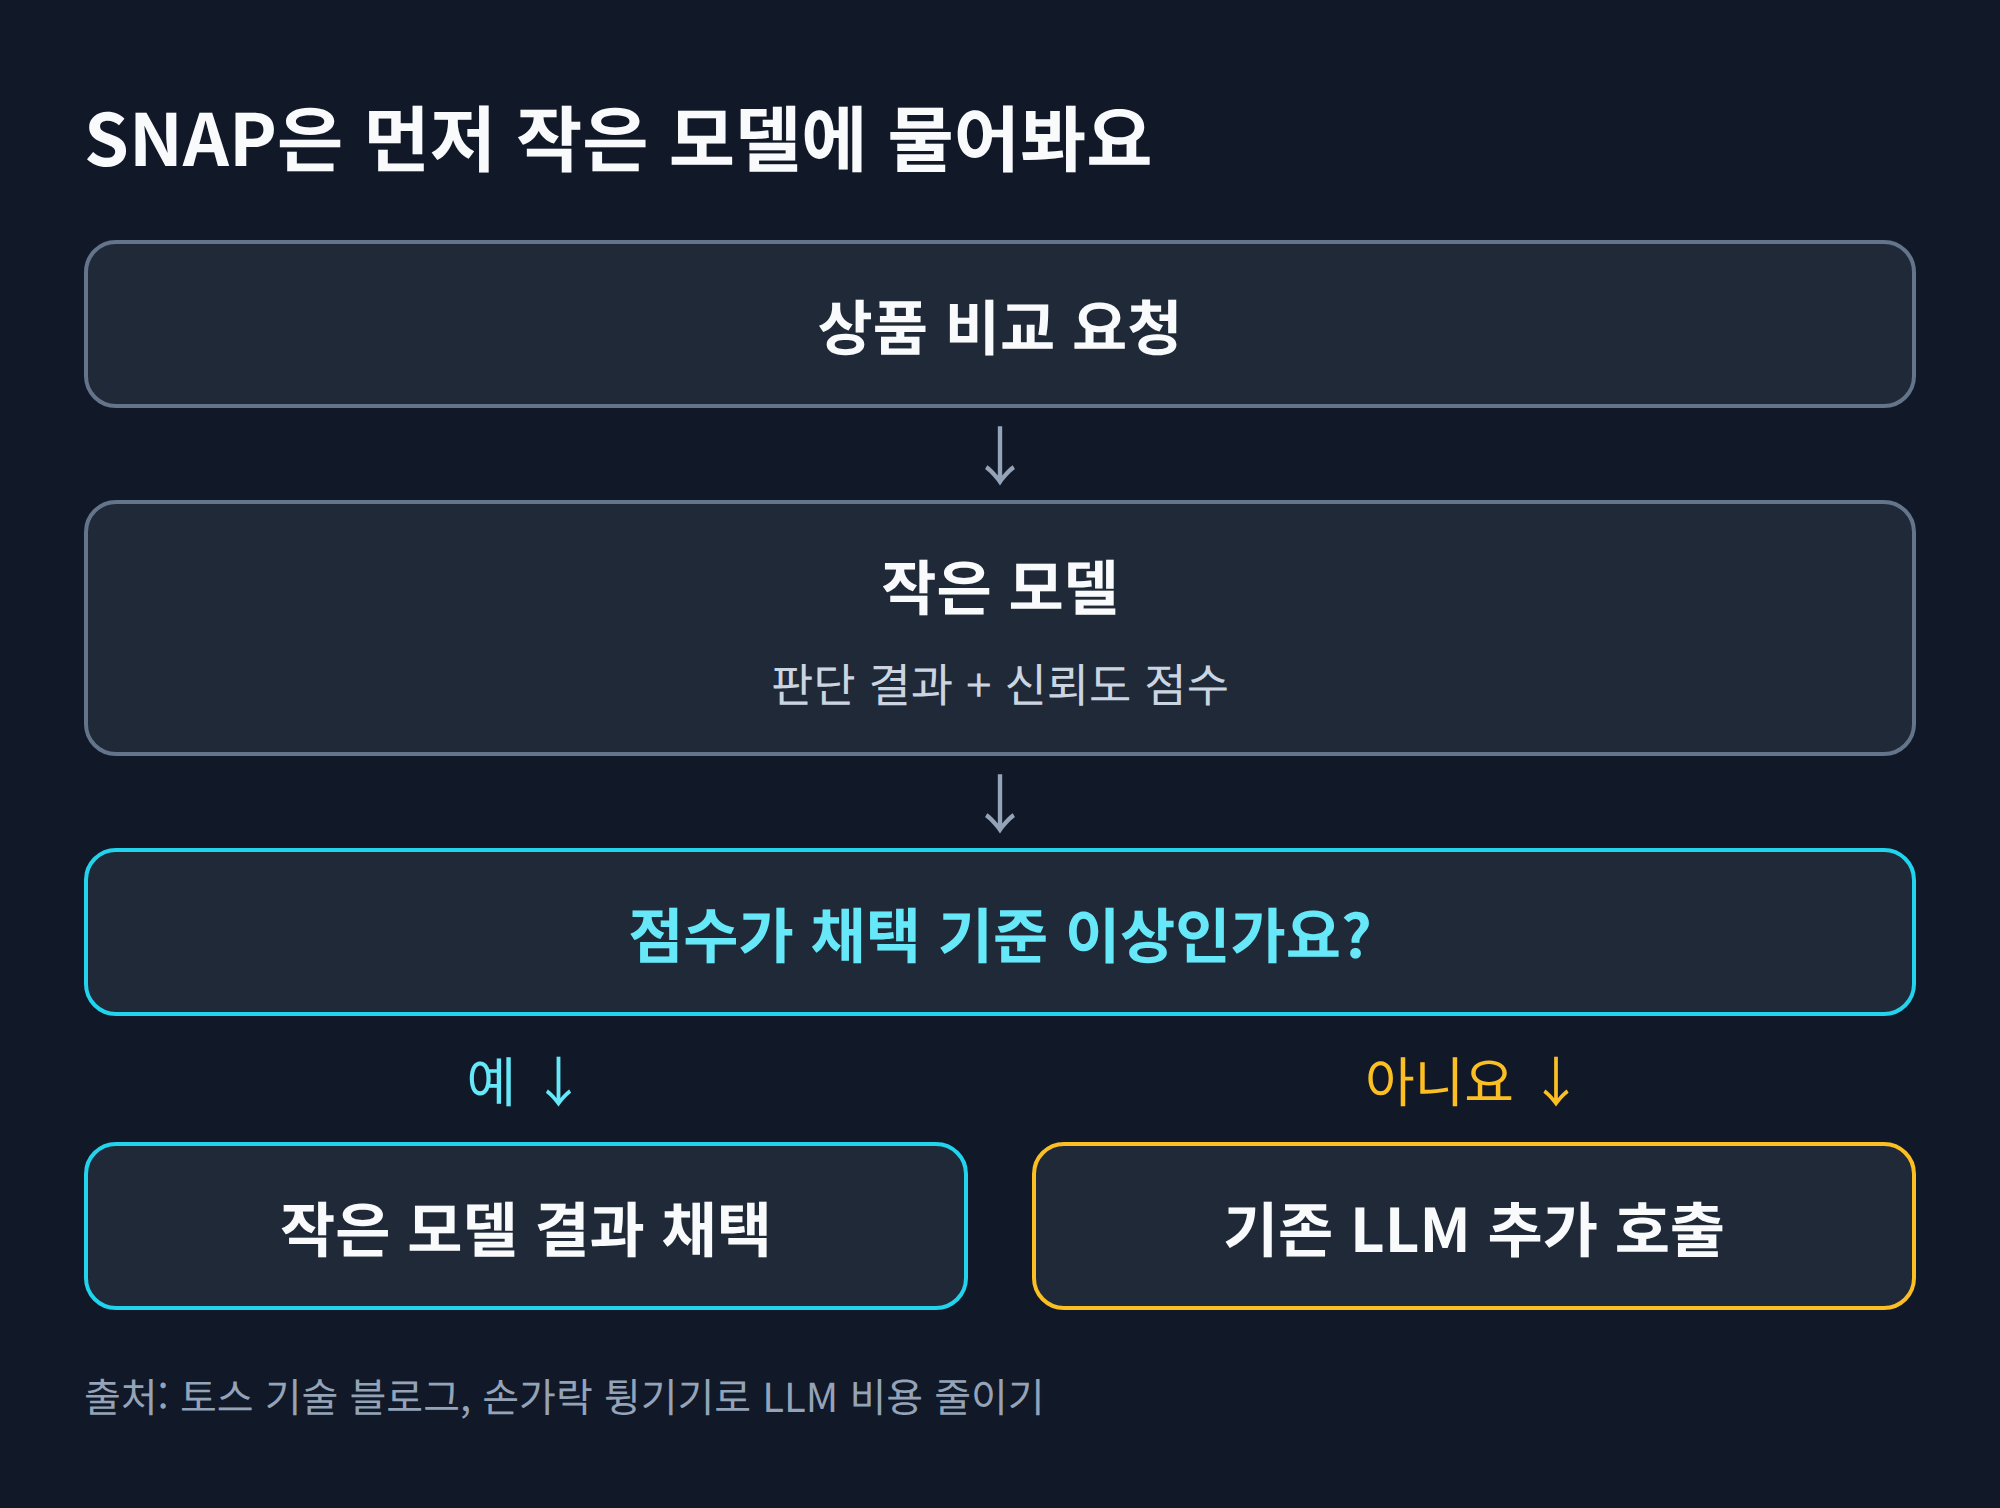
이 연결은 토스의 GenAI Gateway를 통해 이뤄져요. 어려운 요청은 작은 모델을 거친 뒤 LLM도 호출하므로, 모든 요청에서 LLM 대기 시간이 사라지는 구조는 아니에요.
자신 있다는 점수와 실제 정답률은 달라요
모델의 신뢰도 점수가 0.95라고 해서 정답률이 95%라는 뜻은 아니에요. 토스는 검증 데이터에서 점수 기준을 바꿔가며 두 가지를 함께 확인했어요. 채택한 결과가 기존 LLM 판단과 얼마나 일치하는지, 그리고 전체 요청 중 얼마나 많이 채택할 수 있는지예요. 뒤의 비율을 coverage라고 불러요.
| 목표로 정한 LLM 판단 일치율 | 검증 요청 중 작은 모델 결과를 채택한 비율 |
|---|---|
| 99.9% | 34.74% |
| 99% | 51.59% |
| 95% | 72.35% |
품질 기준을 엄격하게 잡으면 작은 모델에 맡길 수 있는 범위가 줄어요. 토스는 첫 배포에 99.9% 조건을 선택했어요. 검증 요청 100,648건 중 34,963건을 채택했고, 그중 기존 LLM과 판단이 달랐던 것은 34건이었어요.
제가 이 숫자로 다시 계산해도 채택 비율은 약 34.74%, 판단 일치율은 약 99.9028%로 원문과 맞았어요.
여기에는 구분할 점이 있어요. LLM과 같은 답을 냈다는 것이 실제 상품의 정답을 맞혔다는 뜻은 아니에요. 기존 LLM 판단을 기준으로 비교한 수치예요. 또 이 값은 모델과 신뢰도 기준을 고르는 데 쓴 검증 데이터에서 측정했으므로, 별도의 독립 시험에서 얻은 정확도로 읽으면 안 돼요.
실제로 줄어든 것은 어느 정도일까요
토스가 공개한 첫 배포 후 약 6일간의 운영 결과에서는 동일 상품 판별 요청의 일별 약 33~37%를 작은 모델이 처리했어요. 오프라인 검증의 34.74%와 비슷한 범위예요. 이 기간 줄어든 LLM 입력 토큰은 약 76억 개, 출력 토큰은 약 4,520만 개라고 해요. 토큰은 모델이 입력과 출력을 처리할 때 세는 텍스트 단위예요.
작은 모델의 응답 속도도 별도로 부하 테스트했어요. L4 GPU 한 장 환경에서 실제 초당 598건을 처리한 구간의 응답 시간 중앙값은 7.24밀리초였어요. 1밀리초는 1,000분의 1초예요. 초당 1,203건 구간에서는 중앙값이 9.02밀리초였고요. 요청의 약 99%가 15.23밀리초 이내에 응답했다는 뜻의 p99 수치도 공개했어요. 모든 시험 구간에서 실패하거나 누락된 요청은 없었다고 해요.
이 속도는 작은 모델 서빙에 대한 부하 시험 결과예요. LLM으로 넘어간 요청까지 포함한 전체 처리 경로의 응답 시간으로 보기는 어려워요. 줄어든 토큰 수도 전체 비용 절감률과는 달라요. 자체 모델을 학습하고 GPU로 운영하는 비용까지 반영한 순절감액은 이 글에서 확인하지 못했어요.
이 전환은 모델 하나를 바꾸는 데서 끝나지 않아요. 토스는 LLM 호출 기록을 작업별로 묶고, 비용이 크면서 응답을 학습 자료로 쓸 수 있는 작업을 골라 학습까지 자동으로 연결했어요. 조건을 충족한 작업은 하루 안에 학습된 모델을 확보할 수 있다고 해요. 모든 요청을 대체하려던 유사 분류 작업에 1~2개월이 걸렸던 경험과 달리, 검증된 일부 요청부터 운영에 적용하는 쪽이에요.
제 생각엔 이 사례에서 가져갈 만한 것은 특정 모델 이름보다 전환 기준이에요. 작은 모델이 전체 업무를 대체할 수 있느냐 대신, 어떤 요청까지 맡겨도 되는지를 먼저 측정한 셈이죠.
확인한 범위
- 기준일: 2026-10-31.
- 읽은 것: 토스 기술 블로그의 SNAP 소개 본문과 그림 목록. 본문에 명시된 검증 수치, 운영 결과, 부하 시험 조건을 대조했어요.
- 직접 확인한 것: 공개된 검증 요청 수, 채택 수, 불일치 수로 coverage와 LLM 판단 일치율을 다시 계산했어요.
- 확인하지 못한 것: 내부 모델과 학습 데이터, 운영 로그, 실제 상품 정답에 대한 정확도, 자체 운영비를 반영한 순절감액. 토스 내부 환경을 재현하거나 모델을 직접 실행하지 않았어요.
- 원문의 분기 구조와 채택 범위 그래프는 공식 글의 Figure 4·5에서도 볼 수 있어요. 이 글에서는 처리 흐름을 도표로, 품질 조건별 채택 범위를 표로 정리했어요.
출처
 토스 기술 블로그, 토스 테크